

Análise de Conteúdo em R: pipeline integrado qualitativo (LLMs) e quantitativo, com foco em corpora brasileiros e dados parlamentares.
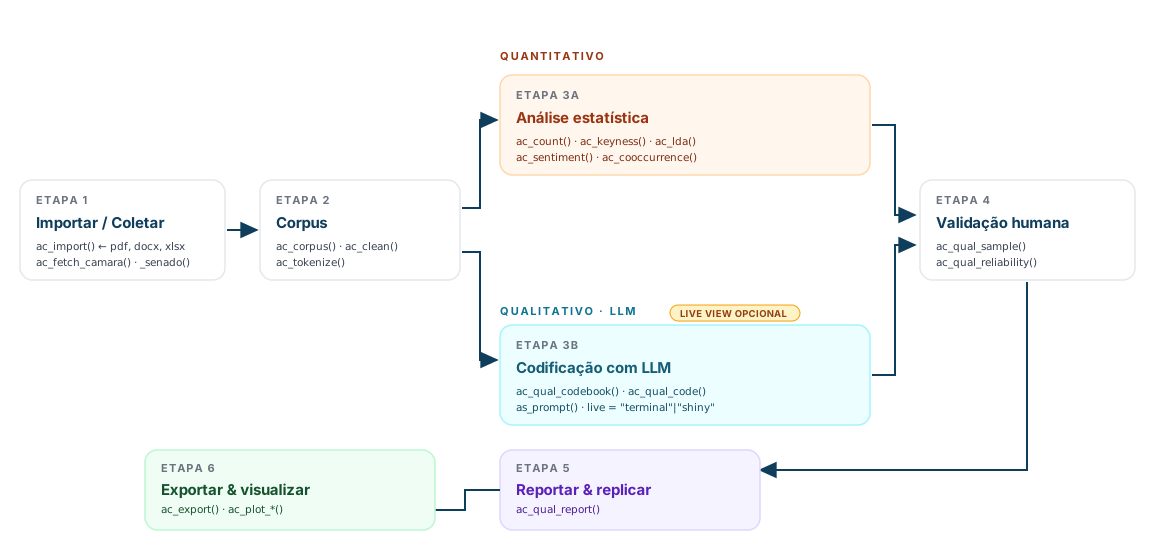
Do texto bruto ao resultado publicável: codebook, LLM, keyness, LDA, sentimento e concordância inter-codificador, num único fluxo reprodutível.
Última leva traz 12 técnicas novas de diagnóstico, escalonamento e dicionários para o módulo quantitativo. Veja a seção “Novidades: diagnóstico de corpus, escalas e dicionários” da vignette quantitativa para exemplos completos:
ac_readability(), Flesch adaptado ao português),
diversidade lexical (ac_lexical_diversity(): TTR, Herdan’s
C, MTLD) e Lei de Zipf (ac_plot_zipf()).ac_kwic()) e colocações com medidas de associação (PMI,
log-likelihood, qui-quadrado) (ac_collocations()).ac_temporal()).ac_wordscores()) e análise de correspondência,
biplot de documentos/grupos × termos (ac_ca()).ac_dictionary()), léxicos de
emoção (ac_emotion()), construção e importação de
dicionários via YAML/CSV (ac_build_dictionary(),
ac_dictionary_save()/ac_dictionary_load(),
ac_dictionary_import()) e validação contra codificação
humana (ac_dictionary_validate()): o mesmo rigor de
ac_qual_reliability(), agora para o método de
dicionário.|
Pesquisador social |
Cientista político |
Analista de políticas públicas |
# 1. Instalar
install.packages("acR")           # via CRAN
remotes::install_github("andersonheri/acR")  # ou versão dev

# 2. Importar seus documentos (PDF, docx, xlsx, csv, txt, imagens com OCR)
library(acR)
corpus <- ac_import("dados/*.pdf")          # ou "planilha.xlsx", "documento.docx"

# 3. Rodar o pipeline mínimo
ac_count(corpus) |> ac_top_terms(n = 10)

# 4. Codificar qualitativamente (requer chave de LLM)
codebook  <- ac_qual_codebook("posicao", "Classifique.",
                              categories = list(favor = "...", contra = "..."))
resultado <- ac_qual_code(corpus, codebook, model = "anthropic/claude-sonnet-4-5")
Vignette completa: Comece aqui → · Quickstart 5 min →
acR fazMódulo qualitativo. Você escreve um codebook (categorias + definições + exemplos), e a LLM classifica cada documento, reportando categoria, nível de confiança via self-consistency e um raciocínio estruturado. Uma amostra é exportada para revisão humana, e a concordância inter-codificador (percent agreement, Cohen’s/Fleiss’ kappa, Krippendorff’s alpha, Gwet’s AC1, F1 macro) é calculada com IC via bootstrap.
Módulo quantitativo. Ferramentas estatísticas
clássicas de análise de conteúdo: frequência de termos e por grupo,
TF-IDF, keyness (χ²/log-likelihood), redes de
co-ocorrência com PMI, análise de sentimento em português (OpLexicon),
modelagem de tópicos com LDA e seleção automática de k. Inclui
também diagnóstico de corpus (legibilidade, diversidade lexical, Lei de
Zipf), concordância/colocações (KWIC, PMI/log-likelihood), séries
temporais, escalonamento ideológico (Wordscores), análise de
correspondência e dicionários multi-categoria customizáveis (incluindo
léxicos de emoção, com validação contra codificação humana).
Visualizações prontas para publicação em ggplot2,
compatíveis com ipeaplot.
Coleta nativa de discursos da Câmara dos Deputados
(por período, partido, UF) e do Senado Federal (via
senatebR).
O pipeline segue Sampaio e Lycarião (2021), referência atual para
análise de conteúdo categorial no Brasil, e Krippendorff (2018). Bardin
(2011) é reconhecida como pioneira, mas o pacote privilegia abordagens
metodologicamente atualizadas. A camada de LLM é inspirada no
quallmer (Maerz e Benoit, 2025) e comunica com múltiplos
provedores via ellmer (Wickham et al., 2025).
Status:
acRestá na CRAN desde agosto/2026 e em desenvolvimento ativo nomain. Contribuições e feedback via issues.
# Via CRAN (estável):
install.packages("acR")

# Versão de desenvolvimento do GitHub:
# install.packages("remotes")
remotes::install_github("andersonheri/acR")

# O módulo qualitativo requer o ellmer para comunicação com LLMs
install.packages("ellmer")O acR tem funções nativas para coletar dados das APIs
abertas da Câmara dos Deputados e do Senado Federal. A coleta da Câmara
é feita por período, partido, UF e tipo de discurso, com paginação
automática e tratamento de erros de conexão. A coleta do Senado é
viabilizada pelo pacote senatebR, de Vinicius
Santos (UERJ), cujas funções o acR estende com uma
interface padronizada ao restante do pipeline.
library(acR)
library(ellmer)
library(dplyr)

# Coletar discursos plenários da Câmara em março de 2024
corpus_raw <- ac_fetch_camara(
  data_inicio   = "2024-03-11",
  data_fim      = "2024-03-15",
  tipo_discurso = "plenário",
  n_max         = 30L
)O objeto ac_corpus é a unidade central do pacote,
carregando o texto, os metadados e o idioma do corpus, aceito por todas
as funções de análise.
corpus <- ac_corpus(
  corpus_raw,
  text  = texto,
  docid = id_discurso
)
A função ac_clean() aplica transformações configuráveis
ao texto, com controle granular sobre cada etapa. Antes de rodar a
limpeza, o pesquisador pode inspecionar e editar as stopwords com
ac_clean_stopwords():
# Construir vetor de stopwords customizado a partir do preset legislativo
sw <- ac_clean_stopwords(
  preset = "pt-legislativo",
  add    = c("nobre", "ilustre", "respeitavel", "honrado"),
  remove = c("lei", "projeto", "constituicao")  # relevantes para a análise
)

# Limpeza com todas as opções
corpus_limpo <- ac_clean(
  corpus,
  lower               = TRUE,
  remove_punct        = TRUE,
  remove_url          = TRUE,
  remove_email        = TRUE,
  remove_hashtags     = TRUE,       # novo: remove #termos separado de símbolos
  remove_mentions     = TRUE,       # novo: remove @usuário separado de símbolos
  remove_stopwords    = "pt-legislativo",
  extra_stopwords     = sw,         # novo: stopwords adicionais ao preset
  protect             = c("PT", "PL", "CCJ"),  # siglas preservadas
  normalize_pt        = TRUE,
  custom_replacements = list(       # novo: substituições livres antes da limpeza
    "pres\\."  = "presidente",
    "dep\\."   = "deputado",
    "v\\.exa" = "vossa excelência"
  ),
  min_char            = 3L,         # novo: descarta tokens com menos de 3 chars
  handle_na           = "remove",   # novo: remove documentos com texto NA
  verbose             = TRUE        # novo: exibe resumo da limpeza
)
O argumento verbose = TRUE exibe um resumo com tokens
antes e depois, quantos foram removidos por etapa e quantos documentos
ficaram vazios após a limpeza: útil para calibrar os parâmetros antes de
rodar o pipeline completo.
codebook <- ac_qual_codebook(
  name         = "temas_plenario",
  instructions = "Classifique o tema principal do discurso parlamentar.",
  categories   = list(
    seguranca_publica  = list(
      definition = "Discursos sobre violência, polícia, crime e segurança pública."
    ),
    economia_fiscal    = list(
      definition = "Discursos sobre impostos, orçamento e política fiscal."
    ),
    politica_social    = list(
      definition = "Discursos sobre saúde, educação e assistência social."
    ),
    orientacao_votacao = list(
      definition = "Orientação de bancada para votação de projetos de lei."
    ),
    outros             = list(
      definition = "Discursos que não se encaixam nas categorias anteriores."
    )
  ),
  mode = "manual"
)chat_obj <- chat_groq(
model = "openai/gpt-oss-120b",
echo = "none"
)
resultado <- ac_qual_code(
corpus = corpus_limpo,
codebook = codebook,
chat = chat_obj,
confidence = "total",
k_consistency = 3L,
reasoning = TRUE,
reasoning_length = "short"
)amostra <- ac_qual_sample(resultado, n = 15) # aleatória (padrão): representativa
ac_qual_export_for_review(sample = amostra, path = "revisao.xlsx", corpus = corpus_limpo)
humano <- ac_qual_import_human("revisao.xlsx")
ac_qual_irr(gold = humano, predicted = resultado,
id_col = "doc_id", cat_col = "categoria")Os resultados de validação com 15 documentos produziram kappa de Cohen de 0.70, concordância substancial segundo Landis e Koch (1977), comparável aos benchmarks de Gilardi, Alizadeh e Kubli (2023).
O acR usa o pacote ellmer como backend, o que
significa que qualquer provedor suportado pelo ellmer funciona
diretamente via chat =. Isso inclui modelos comerciais
(OpenAI, Anthropic, Google, Mistral, DeepSeek), modelos locais via
Ollama, e qualquer serviço que implemente a interface compatível com a
API da OpenAI, como instâncias privadas ou servidores
institucionais.
chat_obj <- chat_groq(model = "openai/gpt-oss-120b", echo = "none")
chat_obj <- chat_google_gemini(model = "gemini-2.5-flash", echo = "none")
chat_obj <- chat_ollama(model = "llama3.2", echo = "none")
chat_obj <- chat_openai(model = "gpt-4.1", echo = "none")
chat_obj <- chat_anthropic(model = "claude-sonnet-4-20250514", echo = "none")
As chaves de API devem ser configuradas no .Renviron com
usethis::edit_r_environ(), nunca diretamente no código.
Para servidores locais compatíveis com OpenAI (LM Studio, llama.cpp,
vLLM), ac_chat_local() dispensa configurar uma chave de API
real:
chat_local <- ac_chat_local(model = "qwen2.5-14b-instruct")

resultado <- ac_qual_code(
  corpus, codebook,
  chat           = chat_local,
  checkpoint_dir = "checkpoints/",  # retoma sem reclassificar em caso de interrupcao
  max_retries    = 2L,              # novas tentativas com espera exponencial
  live           = "progress"       # barra de progresso enxuta para rodadas grandes
)

table(resultado$status)             # ok / resposta_invalida / estouro_contexto / timeout / erro_servidor
attr(resultado, "run_info")$params_efetivos$temperature  # auditar o que o provedor confirmou
Veja a vignette LLM
local em escala para o fluxo completo (dimensionamento de contexto
com ac_estimate_tokens(), checkpoint, tratamento de falhas
e validação por categoria com
ac_qual_reliability(by_variable = TRUE)).
lit <- ac_qual_search_literature(
  concept       = "democratic backsliding",
  n_refs        = 5,
  journals      = "default",
  min_citations = 50,
  chat          = chat_obj
)tokens <- ac_tokenize(corpus_limpo)
contagem <- ac_count(tokens)
ac_plot_top_terms(ac_top_terms(contagem, n = 15))
tfidf <- ac_tf_idf(ac_count(tokens, by = "partido"), by = "partido")
ac_plot_tf_idf(tfidf, by = "partido", n = 10)
keyness <- ac_keyness(tokens, target = "PT", ref = "PL")
ac_plot_keyness(keyness)
sent <- ac_sentiment(corpus_limpo)
ac_plot_sentiment(sent)
cooc <- ac_cooccurrence(tokens, window = 5, min_count = 2)
ac_plot_cooccurrence(cooc, top_n = 30)
lda <- ac_lda(tokens, k = 5)
ac_plot_lda_topics(lda)
# Novidades: diagnóstico, escalas e dicionários
ac_readability(corpus_limpo)
ac_lexical_diversity(corpus_limpo)
ac_kwic(corpus_limpo, pattern = "reforma", window = 5)
ac_collocations(corpus_limpo, measure = "pmi")
dicionario <- ac_build_dictionary(
economia = c("imposto", "orcamento", "deficit"),
saude = c("saude", "vacina", "hospital")
)
ac_dictionary(corpus_limpo, dicionario)
ca <- ac_ca(corpus_limpo, by = "partido")
ac_plot_ca(ca)Um guia rápido do objetivo ao código. Cada linha aponta a função principal e a vignette com o exemplo completo. As demais funções são variações ou utilitários. Veja Funções disponíveis (completo).
| Objetivo | Função | Vignette |
|---|---|---|
| Importar arquivos (PDF, Word, Excel, TXT, imagem com OCR) | ac_import() |
Quickstart |
Criar corpus a partir de data.frame ou vetor |
ac_corpus() |
Quickstart |
| Coletar discursos da Câmara/Senado | ac_fetch_camara() · ac_fetch_senado() |
Estudo de caso |
| Limpar texto (stopwords, URLs, acentos, NAs) | ac_clean() + ac_clean_stopwords() |
Quantitativo |
| Contar tokens | ac_count() |
Quantitativo |
| Top termos + gráfico | ac_top_terms() → ac_plot_top_terms() |
Quantitativo |
| Termos distintivos por documento | ac_tf_idf() → ac_plot_tf_idf() |
Quantitativo |
| Comparar grupos (partido, período, tema, região…) | ac_keyness() → ac_plot_keyness() |
Quantitativo |
| Nuvem de palavras (ggwordcloud) | ac_wordcloud() |
Quantitativo §6 |
| Nuvem comparativa entre 2 grupos | ac_plot_wordcloud_comparative() |
Quantitativo §6.1 |
| Mapear onde termos aparecem no texto | ac_plot_xray() |
Quantitativo |
| Rede de coocorrência | ac_cooccurrence() →
ac_plot_cooccurrence() |
Quantitativo |
| Análise de sentimento (OpLexicon) | ac_sentiment() → ac_plot_sentiment() |
Sentimento |
| Modelagem de tópicos (LDA) | ac_lda() → ac_plot_lda_topics() |
LDA |
| Cluster de documentos (hclust, k-means, PAM) | ac_cluster_documents() →
ac_plot_cluster() |
Cluster |
| Criar codebook para LLM | ac_qual_codebook() |
Qualitativo LLM |
| Classificar textos com LLM | ac_qual_code() |
Qualitativo LLM |
| Amostrar documentos para revisão humana | ac_qual_sample() ·
ac_qual_export_for_review() |
Qualitativo LLM |
| Concordância humano × LLM (Kappa, Krippendorff) | ac_qual_irr() · ac_qual_reliability() |
Qualitativo LLM |
| Escolher o modelo LLM certo | ac_qual_recommend_model() |
Qualitativo LLM |
| Classificar com modelo local em escala (checkpoint, retries, tokens) | ac_chat_local() ·
ac_estimate_tokens() |
LLM local em escala |
| Relatório metodológico reprodutível | ac_qual_report() |
Replicabilidade |
| Exportar (CSV, LaTeX, Excel, RDS) | ac_export() |
Replicabilidade |
| Legibilidade (Flesch em português) | ac_readability() →
ac_plot_readability() |
Quantitativo §10 |
| Diversidade lexical (TTR, Herdan’s C, MTLD) | ac_lexical_diversity() →
ac_plot_lexical_diversity() |
Quantitativo §10 |
| Diagnóstico de corpus (Lei de Zipf) | ac_plot_zipf() |
Quantitativo §11 |
| Concordância/contexto de um termo (KWIC) | ac_kwic() |
Quantitativo §12 |
| Bigramas/trigramas estatisticamente associados | ac_collocations() |
Quantitativo §12 |
| Série temporal/diacrônica de uma métrica | ac_temporal() → ac_plot_temporal() |
Quantitativo §13 |
| Posicionar documentos numa escala (Wordscores) | ac_wordscores() →
ac_plot_wordscores() |
Quantitativo §14 |
| Dicionário multi-categoria (temas, enquadramentos) | ac_dictionary() ·
ac_build_dictionary() |
Quantitativo §15 |
| Léxico de emoções (tipo NRC) | ac_emotion() |
Quantitativo §15 |
| Importar/salvar dicionário (YAML/CSV) | ac_dictionary_import() ·
ac_dictionary_save()/ac_dictionary_load() |
Quantitativo §15 |
| Validar dicionário contra codificação humana | ac_dictionary_validate() |
Quantitativo §15 |
| Biplot documentos/grupos × termos (análise de correspondência) | ac_ca() → ac_plot_ca() |
Quantitativo §16 |
Suite de 561 blocos test_that, cobrindo
boa parte do código (medido com covr::package_coverage()).
Testes de integração com APIs externas (Câmara, Senado, LLM) usam
skip_on_cran() e verificação prévia de disponibilidade: não
bloqueiam CI offline nem o R CMD check da CRAN.
Site completo: https://ahenriquecp.com/acR/, com vignettes navegáveis, referência de todas as funções e changelog.
k, interpretação de tópicos e
visualização.citation("acR")Henrique, A. (2026). acR: Análise de Conteúdo em R.
R package version 0.6.0. ORCID: 0000-0002-1842-2725.
Centro de Estudos da Metrópole (CEM-Cepid), Universidade de São Paulo.
https://ahenriquecp.com/acR/O autor utilizou o modelo de linguagem Claude (Sonnet 5 e Opus 4.8 da
Anthropic), operado por meio do ambiente Claude Code /
Cowork, como ferramenta de apoio à depuração e à estruturação
do código do pacote acR, incluindo a identificação e
correção de bugs, a refatoração de funções, a escrita de testes
automatizados e a redação da documentação (vignettes e roxygen). O autor
assume integral responsabilidade pela correção técnica e científica do
material publicado.
Bardin, L. (2011). Análise de conteúdo. Edições 70.
Gilardi, F., Alizadeh, M., & Kubli, M. (2023). ChatGPT outperforms crowd workers for text-annotation tasks. PNAS, 120(30).
Gwet, K. L. (2014). Handbook of Inter-Rater Reliability. 4. ed. Advanced Analytics.
Krippendorff, K. (2018). Content Analysis: An Introduction to Its Methodology. 4. ed. SAGE.
Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174.
Maerz, S. F., & Benoit, K. (2025). quallmer: Qualitative Analysis with Large Language Models. R package version 0.3.0. https://quallmer.github.io/quallmer/
Priem, J. et al. (2022). OpenAlex: A fully-open index of the global research system. arXiv, 2205.01833.
Sampaio, R. C., & Lycarião, D. (2021). Análise de conteúdo categorial: manual de aplicação. Brasília: ENAP. https://repositorio.enap.gov.br/items/ab24ee50-6283-471d-8024-ce8049b1c5da
Santos, V. (2024). senatebR: Functions to collect data from the Brazilian Senate. R package version 0.1.0. https://github.com/vsntos/senatebR
Souza, M., & Vieira, R. (2012). Sentiment analysis on Twitter data for Portuguese language. PROPOR.
Wang, X. et al. (2023). Self-consistency improves chain of thought reasoning in language models. ICLR.
Wickham, H. et al. (2025). ellmer: Chat with Large Language Models. Posit. https://ellmer.tidyverse.org
MIT © Anderson Henrique (ORCID: 0000-0002-1842-2725). Centro de Estudos da Metrópole (CEM-Cepid), Universidade de São Paulo.